搬瓦工 VPS 磁盘 I/O 占用过高怎么办?iowait 与读写瓶颈排查
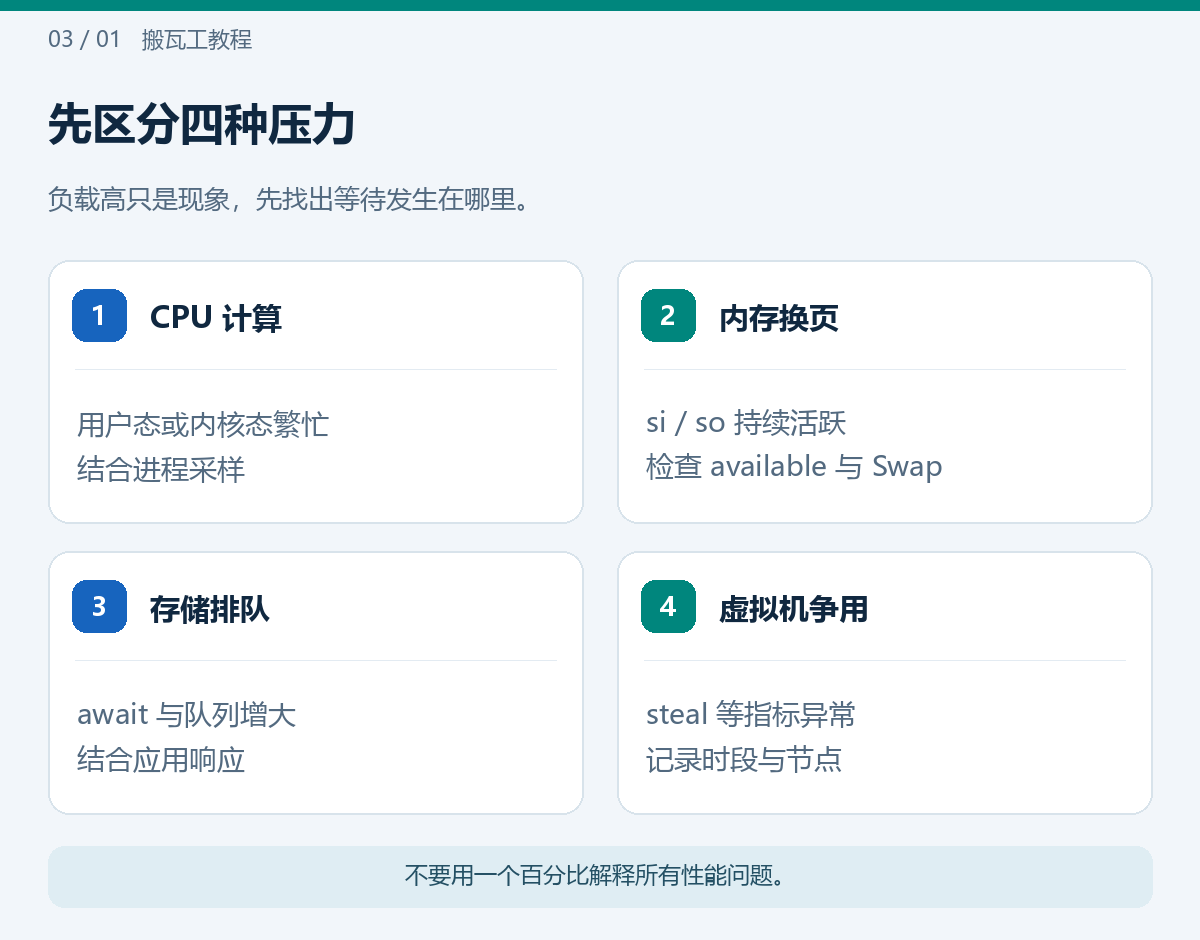
网站很慢,CPU 却没有跑满,问题可能在磁盘等待,也可能来自换页、数据库锁或宿主机资源争用。先把这些情况区分开,才知道该停备份、查查询,还是联系支持。仅凭 top 的 load average 或 wa 数字,不能直接认定磁盘坏了。
下面适用于常见 Debian / Ubuntu KVM VPS。命令主要用于短时观察;系统已经严重卡顿时,不要立即运行大文件写入测试或全盘扫描。CPU 规则可另看 搬瓦工 CPU 占用过高导致 VPS 暂停怎么办。
一、先记录业务慢在什么时间
保留故障时区、起止时间、对应接口或页面,以及是否碰上备份、导入、日志轮转。随后执行:
date -Is
uptime
free -h
vmstat 1 6
df -hT /
把前后样本放在同一时间线上。若可用内存很少,si/so 又在持续变化,I/O 压力可能来自换页;只调整数据库缓存或给磁盘“提速”并不能消除内存不足。
磁盘满、inode 耗尽和存储繁忙是三件事。容量有余量,也可能因大量随机请求而排队;反过来,一块几乎不忙的盘也可能因为空间用尽而拒绝写入。
二、用 iostat 看延迟、队列和吞吐
未安装工具时,在系统负载允许的情况下安装 sysstat:
sudo apt update
sudo apt install sysstat
iostat -xz -y 1 10
-y 跳过自开机以来的首份累计报告;后面是按间隔生成的样本。先确认实际设备,可用 lsblk -f 对照,不要把所有设备行相加,尤其是同时存在分区、LVM 和底层设备时。[1]
| 指标 | 用来观察什么 | 不能直接得出的结论 |
|---|---|---|
| r/s、w/s | 每秒读写请求 | 次数高不必然等于吞吐高 |
| rkB/s、wkB/s | 数据传输速率 | 不是应用单个请求延迟 |
| await、r_await、w_await | 请求平均完成等待,包含排队 | 不能只归因于物理磁盘 |
| aqu-sz | 平均队列长度 | 不存在适合所有存储的统一阈值 |
| %util | 设备忙碌时间比例 | 对并行存储不是万能饱和度指标 |
NVMe、阵列和虚拟磁盘能够并行处理请求。看到 %util 接近 100% 需要继续看延迟和业务响应,不能套用机械盘的单一判断方式。[1]
三、找到正在读写的进程
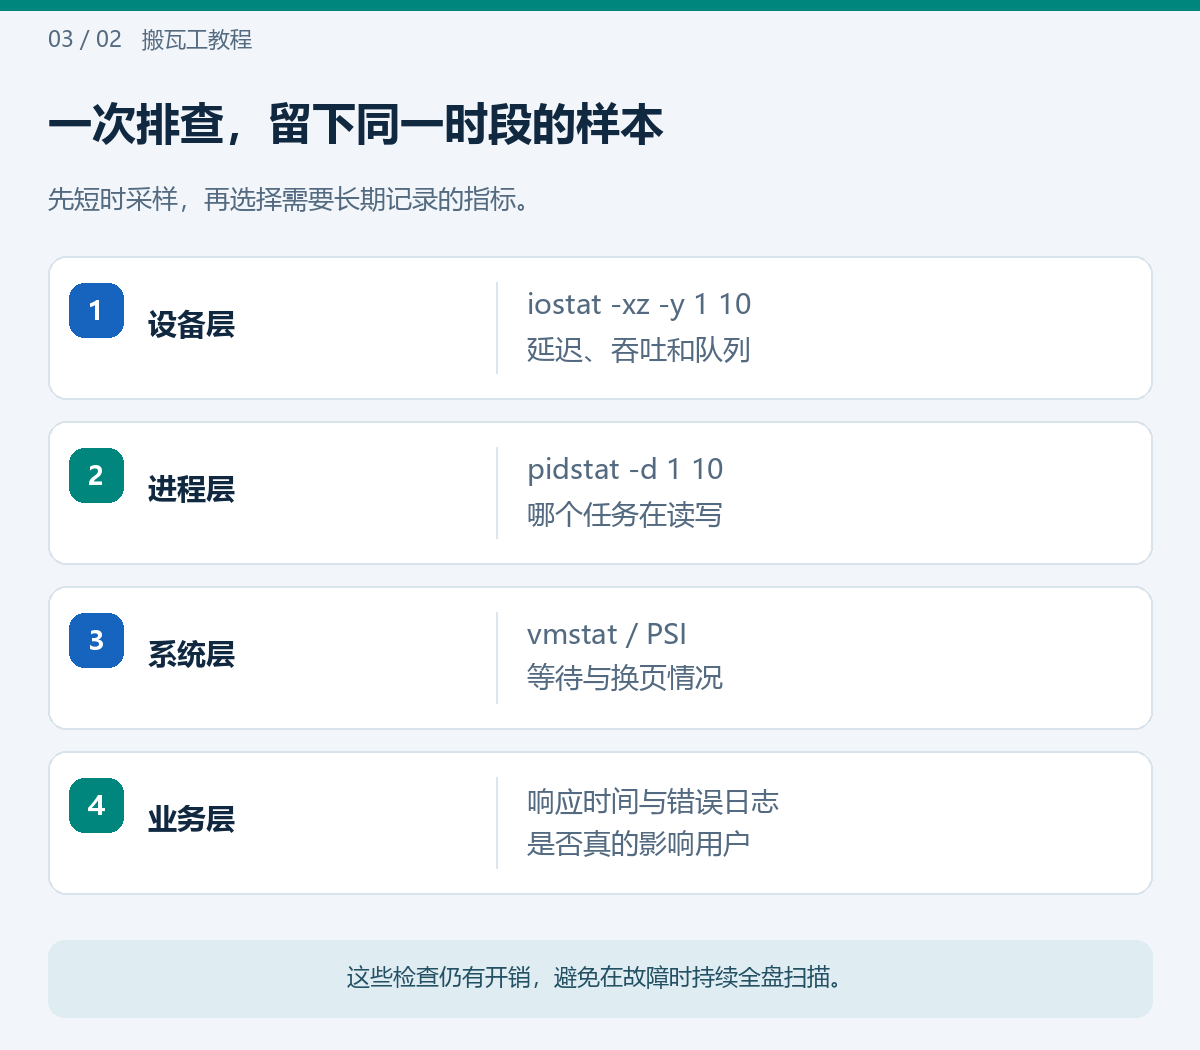
pidstat -d 1 10
pidstat -u -r 1 10
# 查看进程关系,不输出完整命令行中的潜在凭据
ps -eo pid,ppid,user,comm --forest
进程读写统计受缓存、异步写回等因素影响,不一定与设备层逐秒对得上。先找持续异常的任务,再结合它的业务日志、启动时间和容器归属。不要因为某一秒数据库写入排第一,就直接终止数据库。[2]
Docker 场景先检查 docker stats --no-stream,再定位容器中的任务。它的 Block I/O 通常是累计量,不是这一秒的实时读写速度;需要比较两个时间点之间的增量。保存了多少数据,与当前是否正在排队不能混为一谈。
四、结合 PSI 判断等待是否影响整个系统
支持 PSI 的内核可查看:
cat /proc/pressure/io
cat /proc/pressure/memory
cat /proc/pressure/cpu
some 与 full 描述任务受到资源压力阻塞的程度,avg10/60/300 是不同时间窗的平均。它们不是磁盘读写率,也不是“磁盘用了多少百分比”。没有这些文件时,可能是内核配置或环境不提供,不要因此判断没有压力。[3]
实际诊断时可以这样看:同一时间网站超时、I/O PSI 明显上升、await 拉长,同时备份程序大量读取,这是一条比较完整的证据链;若 I/O 数字平稳,而数据库等锁,则应回到 SQL 和事务层处理。
五、先减轻压力,再针对原因处理
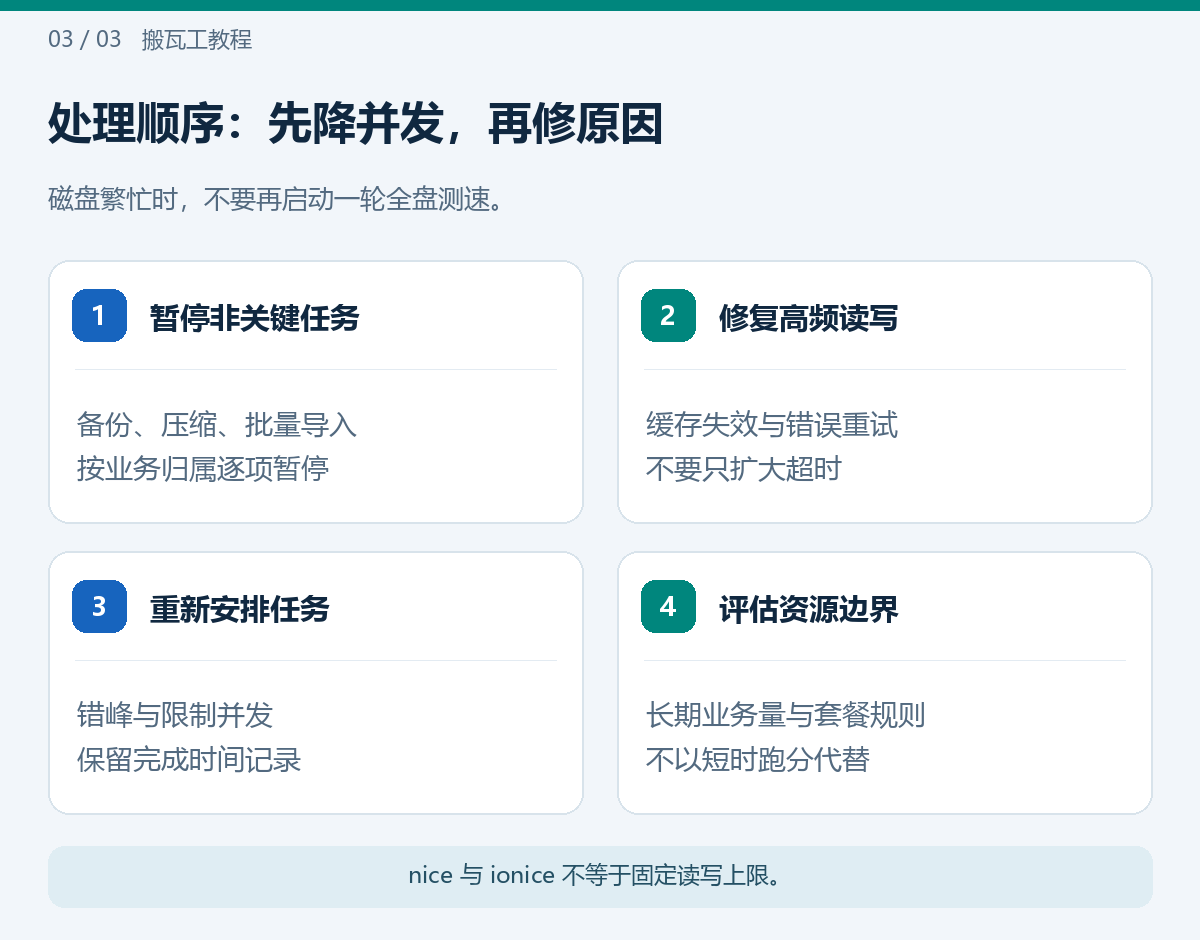
已经确认某个批处理可中断时,优先通过它的服务或容器管理器暂停:
# 占位名称,请换成已确认可中断的真实任务
sudo systemctl stop your-backup-worker.service
这会中断目标任务,不要整段套在不相关服务上。随后重复同样的 10 秒采样,观察响应是否恢复。
**备份与压缩撞车:**把数据库导出、文件备份和压缩错开,并避免上一次任务未完成又启动下一次。可以用锁防止重叠,但锁失败也应有告警,不能悄悄漏掉当日备份。
**日志反复写入:**先处理请求失败、权限错误或死循环,再调整保留策略。仅清空日志而不修原因,会再次产生同样压力。
**数据库大量临时读写:**先找慢查询、索引缺失、并发导入和长事务。不要通过关闭 fsync 等持久化选项换取表面速度,这会改变故障后的数据可靠性。
**内存不足导致换页:**降低应用并发和不必要任务,再评估内存扩容;持续把活跃数据在 RAM 与磁盘之间搬运,通常不是扩大 Swap 就能解决。
六、限速工具与套餐限制不要混为一谈
nice 调整 CPU 调度优先级,ionice 的作用受实际 I/O 调度器影响;它们都不能被当成固定的每秒读写配额。限额需求应结合对应服务的资源控制,并确认宿主环境是否支持。
服务条款对持续存储 I/O 另有约束:页面列出长时间超过 100 MiB/s、持续 4 小时以上的使用情形,并说明告知后仍继续时可能暂停服务。这是使用政策,不是“低于这个速度就一定不卡”的性能保证;也不要把它误解为每个进程单独享有一份额度。[4]
规则中文说明可配合 搬瓦工服务条款中文版 阅读。升级前先看瓶颈究竟是 CPU、内存、I/O 还是程序设计,不要只因硬盘容量变大就认定 IOPS 必定提升。
七、何时联系支持,怎样保留证据
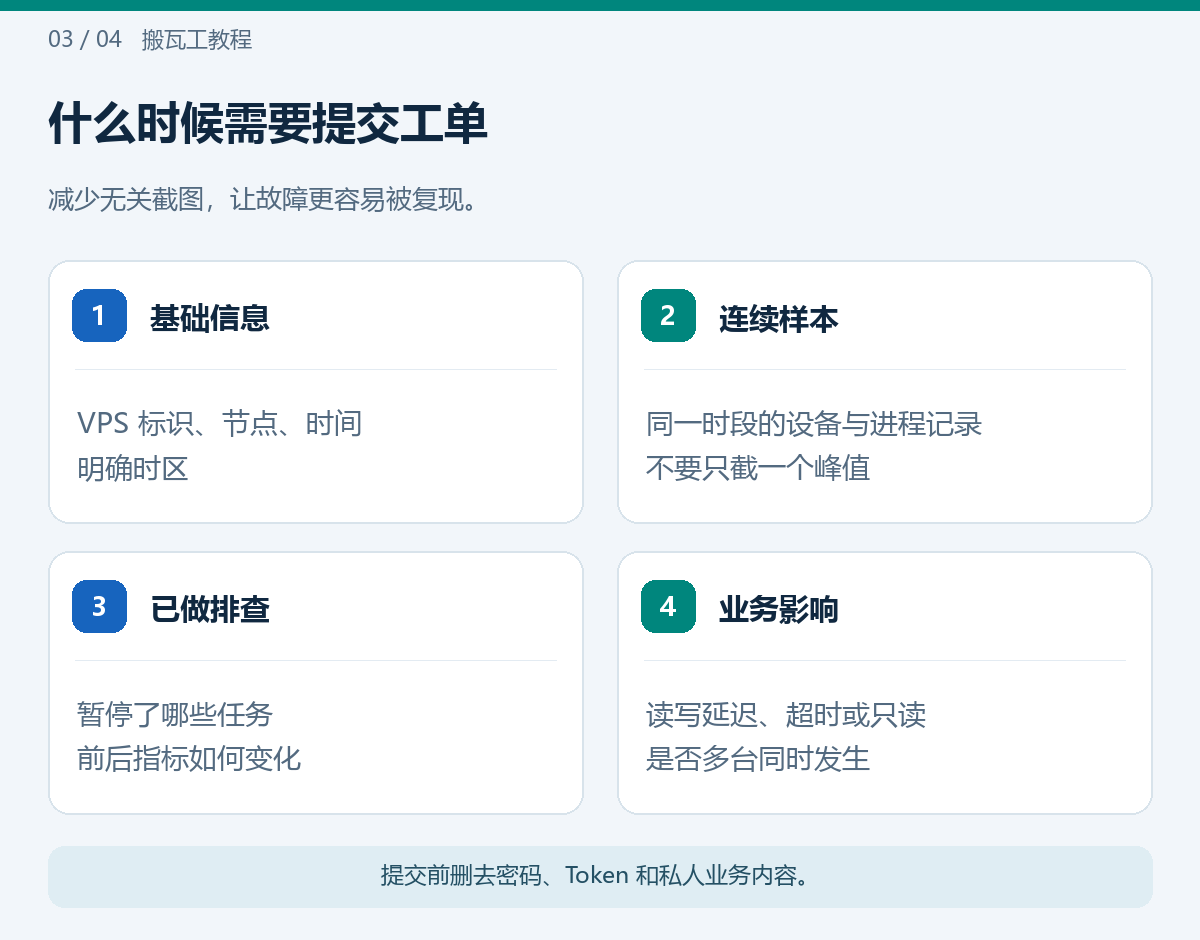
没有明显重任务,却在相同时间段连续出现 I/O error、文件系统只读或异常长的设备等待,应记录节点、VPS 标识、时区和短时样本,提交工单请求核查。不要把一次 Speedtest 或几张 top 截图当成完整证据。
如果只能从控制台进入,参考 搬瓦工 KiwiVM 控制面板完整使用教程。出现文件系统错误时,先保留数据,再按文件系统类型安排救援。快照和独立备份 能提供回退点,但不会自动修好应用写入逻辑。
常见问题
iowait 高就说明硬盘坏了吗?
不能。换页、批处理、虚拟磁盘排队等都可能有关,要结合内核日志、设备延迟与业务现象判断。
可以用 dd 跑满磁盘测试吗?
故障期间不建议。它会增加读写压力,而且单一顺序吞吐不代表数据库随机访问能力。
停掉备份后恢复了,是不是不用备份了?
不是。应调整计划、并发和资源预算,并确认新的备份安排能够按时完成和恢复。