搬瓦工 VPS 监控与告警教程:CPU、内存、磁盘、流量和网站状态
网站打不开时,首先需要知道是整台 VPS 失联,还是 Nginx、数据库或某个接口出了问题。只看 Ping 会漏掉应用错误,只看后台资源曲线又可能发现不了公网访问失败。
这篇采用两套互补的检查:在另一台机器上部署 Uptime Kuma,观察网站是否能被访问;在搬瓦工 VPS 内查看资源,判断磁盘、内存和 CPU 是否接近风险边界。已有的 搬瓦工 CPU 占用过高导致 VPS 暂停怎么办、搬瓦工流量用完怎么办?流量统计和重置时间 可以接着用于故障定位。
一、先确定监控放在哪里
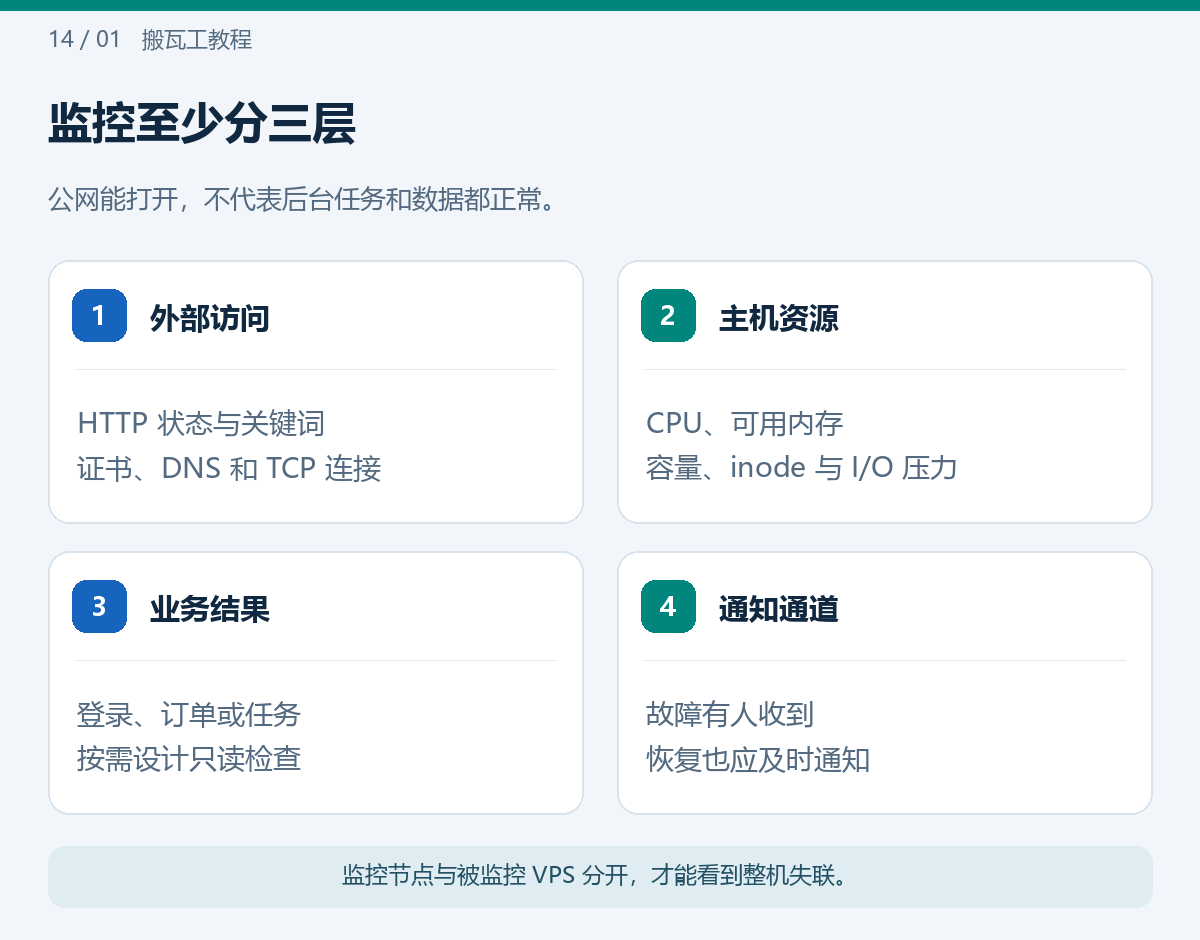
监控和网站放在同一台 VPS 上,仍能记录部分资源变化,但整台机器断网或停机时,告警程序也可能一起失效。对重要网站,优先使用另一台服务器作为监控节点,并为通知保留独立通道。
| 检查对象 | 需要回答的问题 | 不应据此推断什么 |
|---|---|---|
| HTTPS 状态和关键词 | 页面是否返回正确内容 | 首页正常不代表登录、数据库都正常 |
| TCP 端口 | 对应连接是否建立 | 端口开放不代表应用处理正确 |
| CPU、内存、磁盘 | 资源是否出现持续压力 | 瞬时高值不一定是故障 |
| 证书 | 当前访问链路的证书是否有效 | CDN 边缘证书有效不代表源站证书正常 |
| 月流量 | 剩余额度是否够用 | 系统网卡累计字节不等于平台结算用量 |
Uptime Kuma 提供 HTTP、关键词、TCP、DNS、Push 等监控类型和多种通知方式。这里不需要把所有功能一次开全,先覆盖正在运行的核心服务。[1]
二、部署 Uptime Kuma,先不把管理端口公开
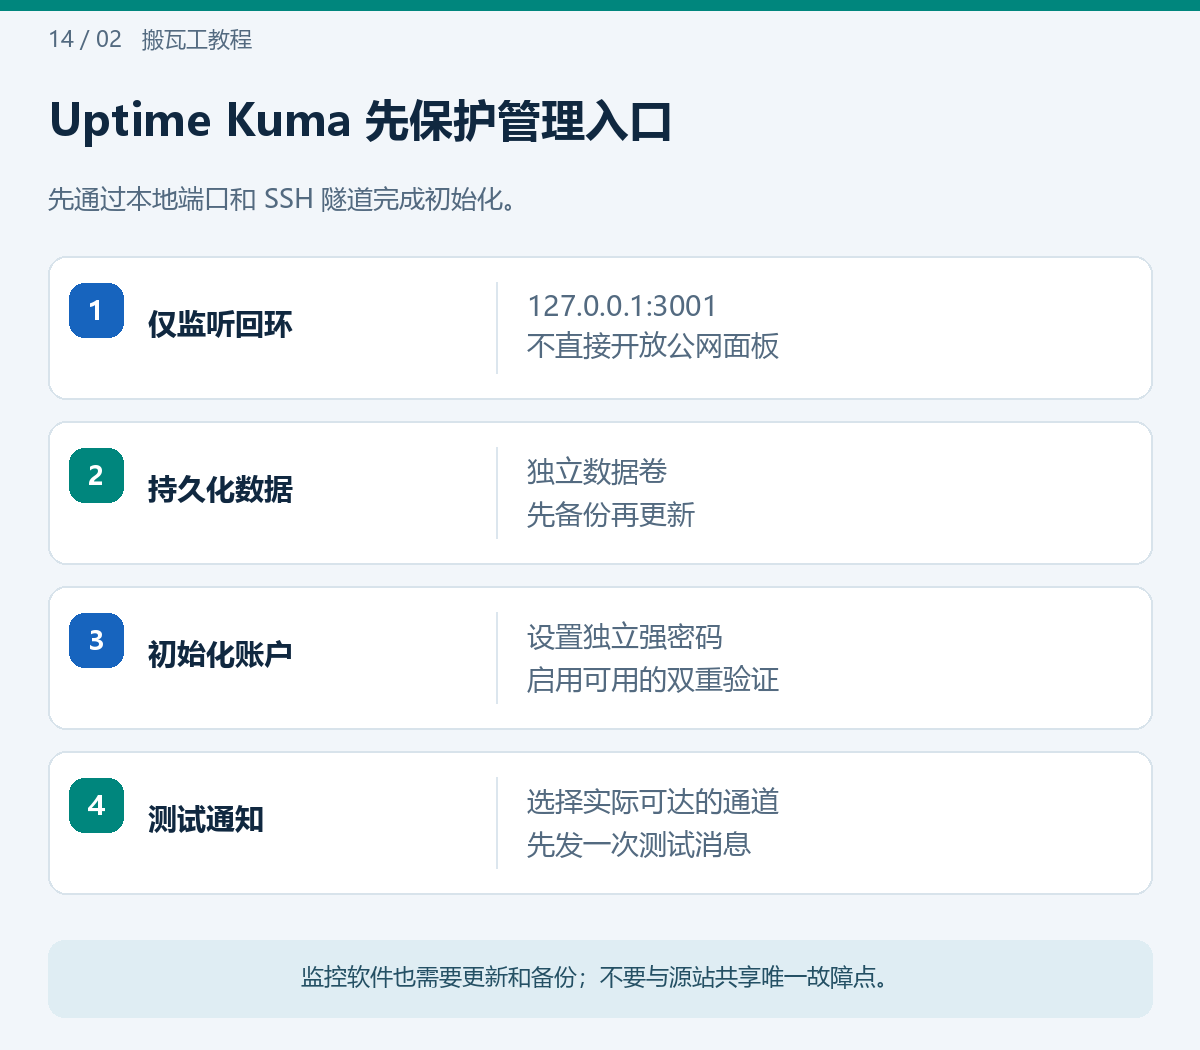
下面在已经装好 Docker Compose 的独立 Linux 监控节点上操作。不要把旧实例的数据目录混进新项目,也不要删除已有同名卷。建立新的项目目录,将包内 configs/compose.yaml 放进去:
name: bwh-monitor
services:
  kuma:
    image: louislam/uptime-kuma:2
    restart: unless-stopped
    ports:
      - "127.0.0.1:3001:3001"
    volumes:
      - kuma-data:/app/data
    logging:
      driver: json-file
      options:
        max-size: "10m"
        max-file: "3"
volumes:
  kuma-data:
2 是主版本标签,不是永远不变的镜像。首次部署后记录实际版本;以后更新前先看发布说明并备份数据。数据卷使用本地存储,不放在项目不支持的 NFS 文件系统上。
在项目目录执行:
sudo docker compose config
sudo docker compose up -d
sudo docker compose ps
在本地电脑开 SSH 隧道,用户名、IP 和 SSH 端口都换成监控节点的实际值:
ssh -N -L 3001:127.0.0.1:3001 -p 22 [email protected]
然后在本地浏览器访问 http://127.0.0.1:3001,创建管理员账户,设置独立密码和可用的双重验证。确需远程浏览器长期访问时,再部署 HTTPS 反向代理和访问限制,而不是直接把 3001 暴露到所有网卡。SSH 隧道中断时,页面暂时打不开并不等于监控服务停止。
三、先建立一个真正有意义的网站检查
新增 HTTP(s) 监控时,填写自己的 HTTPS 域名,明确期望状态码。公开静态页通常期望 200;受保护的接口要单独设计,不能把 401 或登录页误判为业务成功。
建议从 60 秒检查间隔、连续几次失败后告警开始试用,再根据可接受的发现时间和监控负担调整。这里的数值是配置建议,不是服务承诺,也不是 API 调用额度。
关键词监控适合确认页面里确实有指定内容,但关键词要稳定,不能选择日期、随机推荐语或经常变化的文章标题。重要业务可增加一个只读健康检查入口,返回简短的状态,不输出数据库密码、环境变量或系统详细信息。不要为了监控反复创建订单、发邮件或写入测试数据。[1]
检查经 Cloudflare 代理的域名,得到的是访客路径的结果。还需检查源站时,另设受控入口,并核对证书名称和访问规则,不能在公网关闭源站限制来迁就监控。
四、主机资源怎么看,阈值怎么定
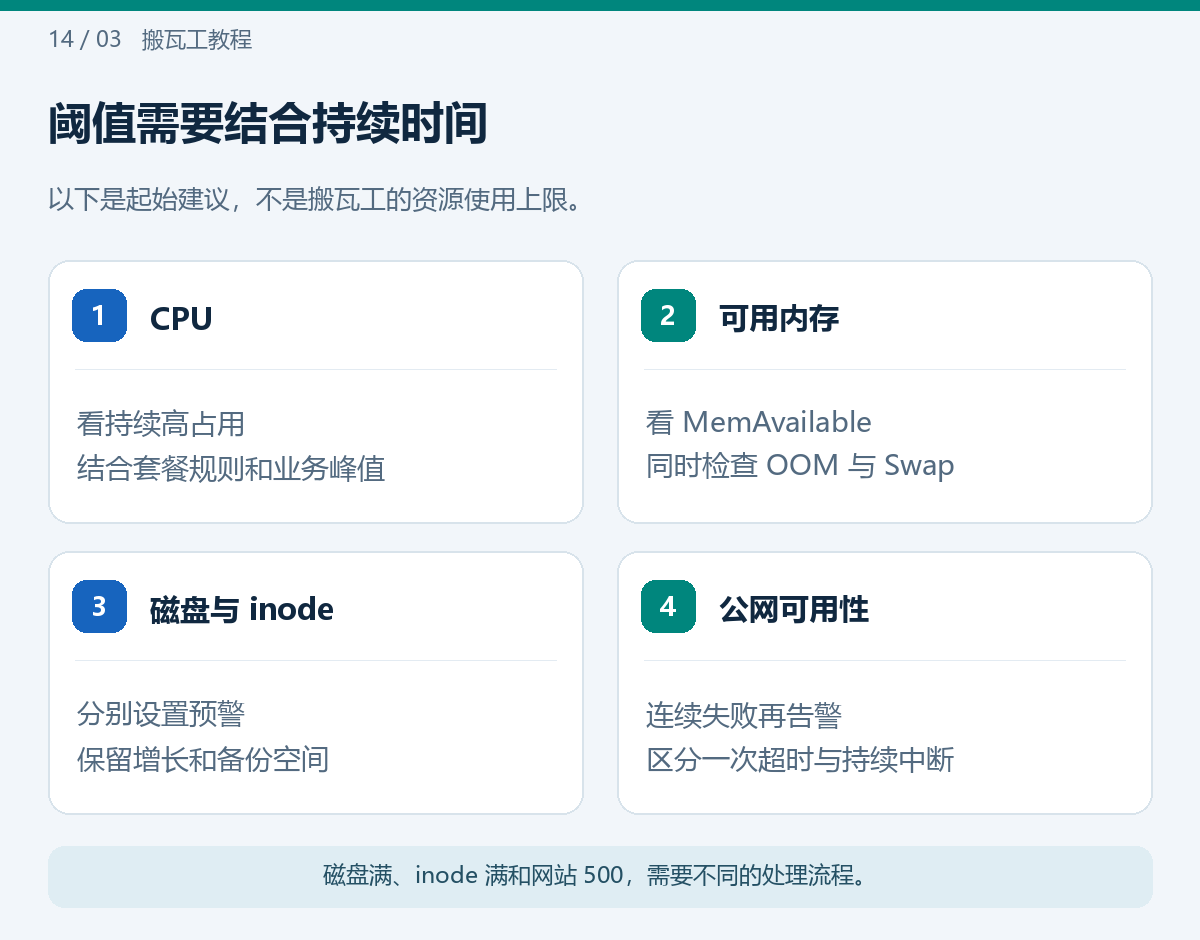
资源监控应结合持续时间。CPU 偶尔冲高、Linux 使用内存做缓存都很常见;持续资源压力、OOM 记录、可用磁盘不断下降才更值得追踪。
可以先建立如下预警,再用几天实际记录调整:磁盘剩余容量低于 20% 提醒,低于 10% 升级处理;inode 也单独检查。容量很小的文件系统还应增加绝对剩余空间阈值,避免“剩余 15%”实际只剩几百 MB。
内存以 MemAvailable 观察还能分配多少,配合 OOM、Swap 和业务延迟判断。CPU 则同时看采样占用、运行队列以及套餐允许的持续使用范围,不能把 load average 直接写成 CPU 百分比。[3][4]
包内 scripts/resource-readonly.py 使用 Python 3 标准库读取本机资源,不安装代理、不修改服务、不发送数据。执行示例:
python3 scripts/resource-readonly.py --path /
它输出一段 JSON,包括短时 CPU 忙碌比例、内存可用比例、指定文件系统空间与 inode 情况。此脚本只是单次采样,不会自动发邮件;阈值项是本地预警,不是搬瓦工的资源结算规则。容器内读取到的 /proc 视图也可能不同,应在 VPS 宿主系统执行。
如果挂了独立数据盘,还应针对挂载点再运行一次。只检查 /,发现不了另一个文件系统先被数据库写满。
五、流量告警不要拿重启后的网卡统计代替账单统计
系统网卡计数可能因重启、接口变化或统计工具启用时间不同而改变;Docker 的多层接口还可能导致重复统计。它适合看当前速率和趋势,不适合直接宣称“本月套餐已经用了多少”。
月流量应以 KiwiVM 显示的已用、限额和重置时间为依据。使用 API 定期读取时,要按当前接口文档确认字段、单位和时间戳,并设置合理间隔;不要盲目复用未知接口或每秒轮询。搬瓦工流量用完怎么办?流量统计和重置时间 中的统计入口适合人工复核;搬瓦工 KiwiVM 控制面板完整使用教程 可用于确认运行状态和配额提示。
预警可分两级,例如达到 70% 先观察、达到 90% 处理。只是把阈值调高不能解决异常出站、重复备份或程序反复下载的问题。
六、通知要包含处理所需的信息
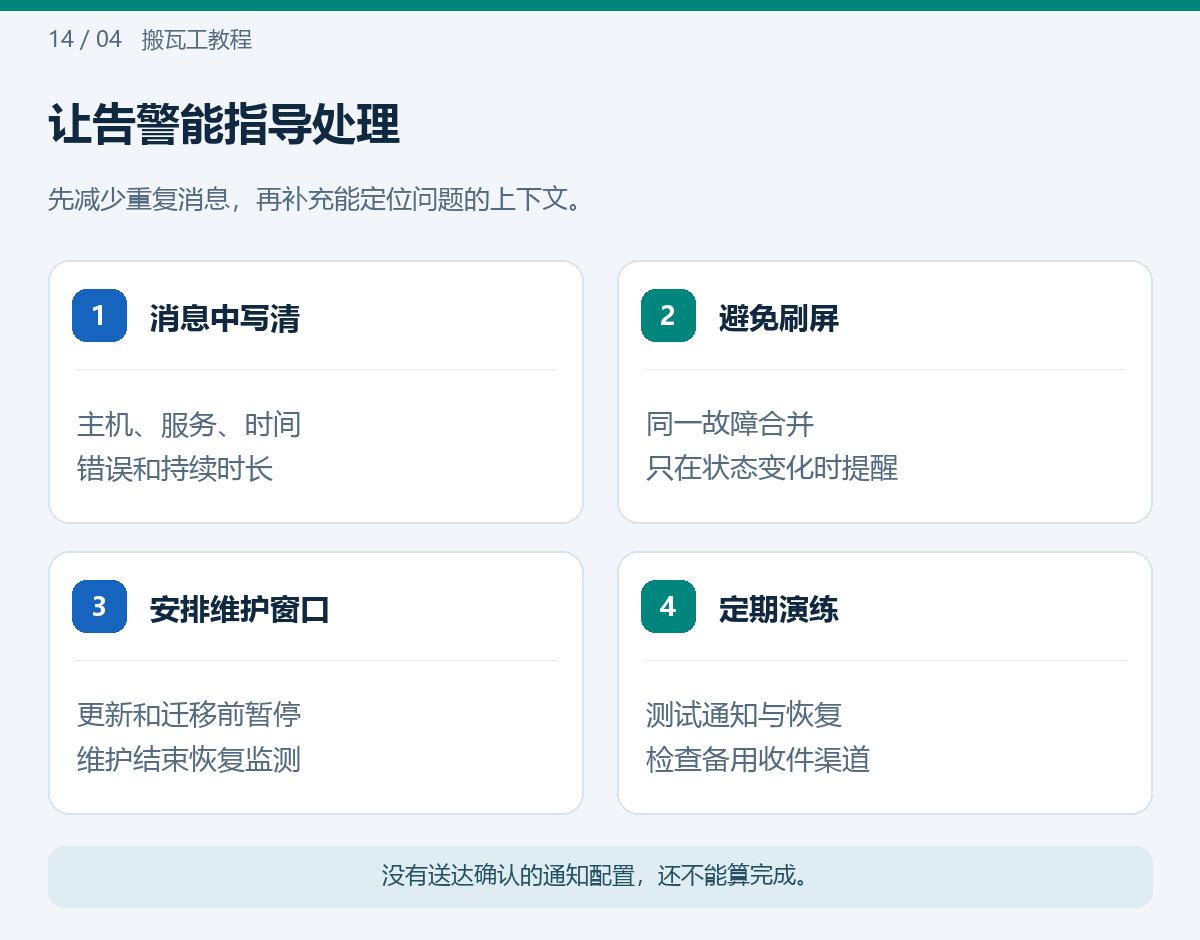
选择实际可达的通知渠道,在 Uptime Kuma 中先发送测试通知,再把它关联到监控项。生产告警建议带上机器别名、服务名、发生时间和时区、连续失败次数或持续时长,以及错误摘要。
同一故障持续存在时,不需要每分钟把相同消息发一次。设置适当重试和重复提醒策略,恢复时再发恢复通知。凌晨计划升级前安排维护窗口,结束后确认监控重新启用。不同版本的字段名称可能有变化,应以页面提供的选项为准。[1]
不要通过关闭生产站来“测试告警”。可以创建一个明确不会影响业务的测试监控,暂时指向自己控制的不存在路径,观察失败与恢复两种消息是否都收到。
七、监控本身也要维护
备份 Uptime Kuma 数据卷,保留监控项目与通知配置的恢复方式。通知 Token、SMTP 凭据和 Push URL 都按敏感信息保存,不能放在公开状态页和文章截图里。
监控失联、收件邮箱停用、Token 过期都可能造成“服务出故障却没人知道”。每月做一次通知测试,更新前先备份,检查状态页没有暴露内部地址。备份和恢复方法可参考 搬瓦工快照与自动备份教程,但监控节点的独立备份仍要另做。
常见问题
Uptime Kuma 能直接代替全部系统资源监控吗?
它主要负责可用性和通知。资源长期趋势需要相应采集与存储,单次脚本输出并不等于完整监控平台。
Ping 正常,网站返回 500,为什么没告警?
监控只检查了网络可达性。增加 HTTP 状态、关键词或业务健康检查,才能覆盖应用层问题。
使用很短间隔是不是一定更好?
更短间隔增加请求和数据量,也可能放大瞬时波动。先确定需要多快发现故障,再设置间隔、重试和通知策略。
相关阅读
参考资料